Generalização e regularização
Pré-requisitos: Redes Neurais e Losses e Otimização
Uma rede pode acertar quase todos os exemplos que recebeu e ainda assim errar em exemplos novos. Veja três modelos ajustados aos mesmos dados artificiais. As linhas representam suas previsões, e os pontos representam as observações usadas no treino.
Se olharmos apenas para os exemplos de treino, o terceiro modelo parece o melhor: sua curva passa perto de quase todos os pontos. Mas repare como ela se contorce entre eles. Os dados têm pequenas variações aleatórias, e o modelo tenta reproduzir até essas irregularidades. Ele pode acertar os exemplos conhecidos e fazer previsões ruins justamente nos pontos que não vimos.
O segundo modelo não acerta cada ponto, mas acompanha melhor a tendência. O primeiro é simples demais para representar a curvatura. Essa comparação mostra a diferença entre ajustar os exemplos disponíveis e generalizar: queremos que o modelo também funcione com dados novos, não apenas com os que usou para aprender.
Regularização
Uma rede pode aprender padrões reais dos dados, mas também detalhes acidentais. Por exemplo, ao classificar gatos, ela poderia depender demais do fundo das fotos, caso muitos gatos do treino aparecessem na grama. A regularização ajuda a evitar que o modelo dependa excessivamente dos exemplos conhecidos.
Até aqui, o objetivo do treinamento era minimizar a perda:
Podemos acrescentar um custo para soluções mais complexas. Na regularização de pesos, esse custo é calculado a partir dos valores dos próprios pesos da rede. A ideia é:
Aqui, complexidade significa uma penalização escolhida para os pesos, não a quantidade de neurônios ou uma medida universal de quão complexa é a rede. Duas maneiras comuns de calculá-la são \(L_1\) e \(L_2\):
Os \(w_i\) são pesos aprendidos pela rede. Em \(L_1\), somamos seus módulos; em \(L_2\), seus quadrados. Veja o cálculo para seis pesos ilustrativos:
| Peso | Valor | Módulo | Quadrado |
|---|---|---|---|
| \(w_{1}\) | 0,2 | 0,2 | 0,04 |
| \(w_{2}\) | -0,5 | 0,5 | 0,25 |
| \(w_{3}\) | 5,0 | 5,0 | 25,00 |
| \(w_{4}\) | -1,2 | 1,2 | 1,44 |
| \(w_{5}\) | 0,3 | 0,3 | 0,09 |
| \(w_{6}\) | -0,1 | 0,1 | 0,01 |
| Total | 7,30 | 26,83 |
O peso \(w_3=5\) responde por cerca de 68% de \(L_1\), mas por 93% de \(L_2\). Assim, \(L_2\) penaliza especialmente pesos grandes; \(L_1\) pode levar alguns pesos a zero. Isso incentiva soluções menos dependentes de pesos grandes, mas não identifica quais características são relevantes: a penalização considera os valores dos pesos, não seu significado.
A taxa de regularização \(\lambda\) controla quanto essa penalização importa. Com \(\lambda=0\), ela desaparece. Quanto maior \(\lambda\), maior o custo de manter pesos grandes.
Com \(L_2=26{,}83\), escolher \(\lambda=0{,}01\) adiciona \(0{,}2683\) à perda; com \(\lambda=0{,}1\), adiciona \(2{,}683\). Os pesos são os mesmos, mas a penalização passou a importar mais. Durante o treino, isso pode levar a outros pesos.
Se a penalização for excessiva, o modelo pode sofrer underfitting. Por isso, ajustamos \(\lambda\) pela validação. Não confunda essa taxa com a taxa de aprendizagem, que controla o tamanho das atualizações dos pesos.
Dropout
Imagine uma rede que reconhece gatos e acabe dependendo demais de um pequeno grupo de neurônios. O dropout desativa aleatoriamente algumas ativações durante o treinamento. A cada passagem, o modelo precisa funcionar mesmo sem poder contar com todas as unidades.

Na figura, as unidades desligadas deixam de contribuir para a previsão daquela passagem. Na próxima, outras unidades podem ser escolhidas. Os pesos não são apagados, e na previsão final o dropout é desativado. Isso pode reduzir a dependência excessiva de combinações específicas de unidades e melhorar a generalização.
Early stopping
Uma época (epoch) é uma passagem completa pelos exemplos de treino. Treinar por mais épocas geralmente diminui a perda nesses exemplos, mas não garante melhores previsões com dados novos.
O early stopping observa o erro de validação e interrompe o treino quando ele deixa de melhorar. No gráfico, o erro de treino continua caindo enquanto o de validação começa a piorar.
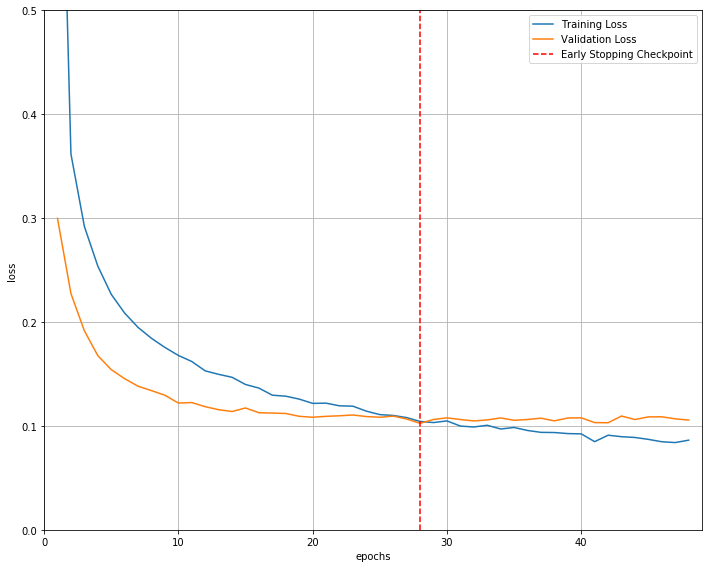
Para não parar por uma oscilação isolada, esperamos algumas épocas por uma nova melhora. Esse intervalo é a paciência. Podemos guardar e recuperar os pesos da melhor época, que pode ocorrer bem antes da parada efetiva. Usamos a validação, não o conjunto de teste, para fazer essa escolha.
Normalização
Uma camada transforma as entradas em vários números, chamados ativações. Alguns podem ficar muito maiores do que outros. A normalização compara cada valor com a média e a dispersão de um grupo, recentrando e reescalando os números. Isso costuma facilitar os ajustes durante o treinamento.
O que muda entre BatchNorm e LayerNorm é o grupo utilizado:

Imagine a ativação 2. Em uma camada densa, a BatchNorm pode compará-la com os valores (2, 4, 8) da mesma característica em três exemplos do lote. A LayerNorm pode usar (2, 5, 8, 11), características diferentes de um único exemplo.
Em ambos os casos, subtraímos a média do grupo e dividimos pelo desvio-padrão. Antes de qualquer reajuste aprendido, o valor 2 se torna aproximadamente −1,07 na BatchNorm e −1,34 na LayerNorm. Números negativos aqui apenas indicam valores abaixo da média do respectivo grupo.
A rede ainda aprende ajustes de escala e deslocamento após essa transformação. Durante o treino, BatchNorm normalmente usa as estatísticas do lote; na avaliação, costuma usar estimativas acumuladas. LayerNorm usa as características de cada exemplo em ambos os casos. Normalização não substitui regularização.
CPU e GPU
Quando você abre um programa, o computador precisa executar instruções: buscar dados na memória, fazer contas, comparar resultados e decidir o que fazer em seguida. O circuito responsável por esse trabalho é um processador.
A CPU (Central Processing Unit) é o processador de uso geral. Ela executa partes do sistema operacional e dos aplicativos, responde a entradas do teclado, organiza tarefas e toma decisões como “se aconteceu isto, faça aquilo”. Essas operações são variadas e muitas dependem do resultado da anterior. Por isso, CPUs dedicam bastante hardware a controlar instruções, acessar a memória rapidamente e terminar tarefas individuais com pouca demora. As CPUs modernas também têm vários núcleos e executam operações em paralelo.
Agora imagine um jogo. Para mostrar um único quadro na tela, o computador precisa calcular as cores e a iluminação de muitos pontos da imagem. Grande parte desse trabalho pode ser dividida: enquanto uma unidade calcula um ponto, outras calculam pontos diferentes. A GPU (Graphics Processing Unit) foi desenvolvida para esse tipo de tarefa, com muitas unidades capazes de realizar operações semelhantes ao mesmo tempo.

Isso explica a diferença principal: a CPU é especialmente versátil e rápida para tarefas diversas; a GPU busca realizar uma grande quantidade de contas em conjunto. Não significa que cada conta individual na GPU seja mais rápida. O ganho aparece quando milhares de operações independentes podem ser distribuídas entre muitas unidades de execução.
As redes neurais também têm esse tipo de trabalho. Em uma camada, muitos neurônios combinam números por multiplicações e somas; partes desses cálculos podem acontecer em paralelo. Ao treinar, repetimos essas operações em muitos exemplos e camadas. Por isso, GPUs podem acelerar tanto o processamento de gráficos em jogos quanto o treinamento e o uso de modelos de IA.
A CPU normalmente continua coordenando o programa e enviando operações e dados à GPU. E nem sempre compensa usá-la: tarefas pequenas, operações muito dependentes entre si ou o tempo de transferir dados podem eliminar a vantagem. A GPU acelera certos cálculos, mas não torna o modelo mais preciso por si só.
Exercício
Observe as curvas de perda e marque as alternativas mais adequadas. Algumas questões têm mais de uma resposta correta. Depois, confira a explicação.
Caso A

Caso B

Caso C

Caso D
